Modelo lógico de prontidão para Recuperação de Desastres (DR)
Resumo
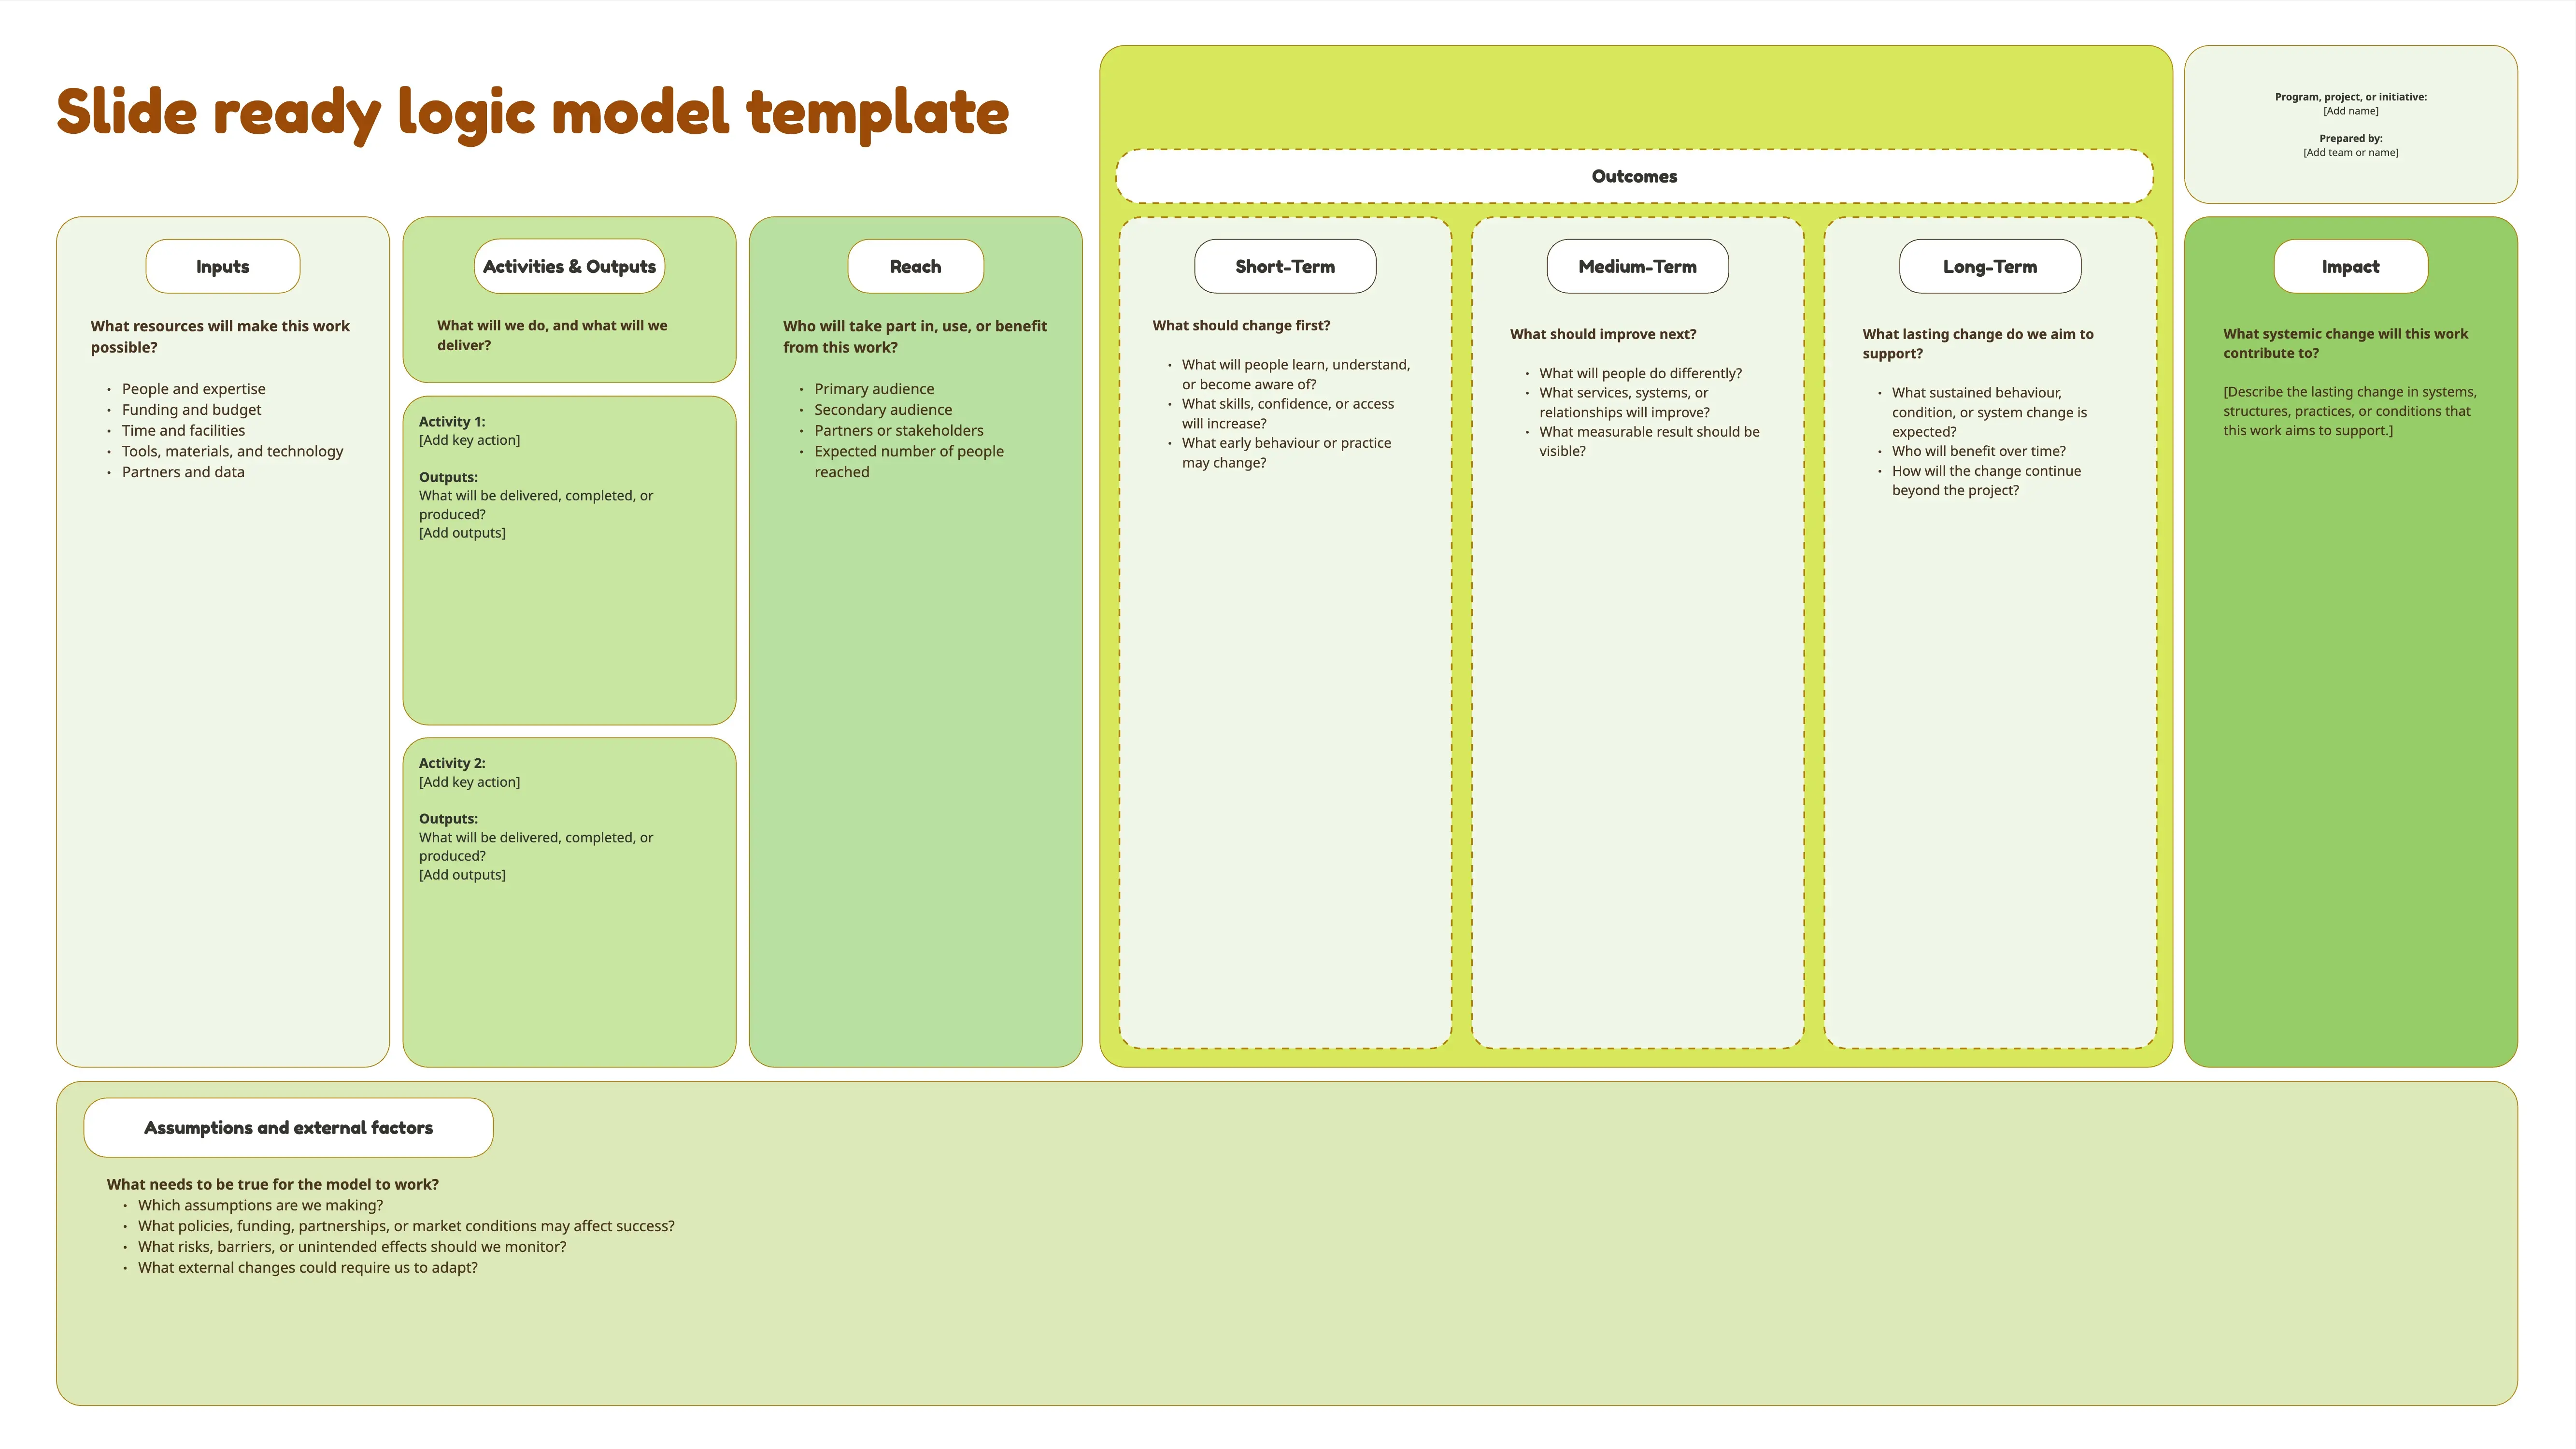
O Modelo lógico de prontidão para recuperação de desastres (DR) é uma estrutura de planejamento estratégico e comunicação que mapeia a cadeia completa de causa e efeito de um programa de recuperação de desastres. Ele traça o caminho de Entradas (recursos e investimentos) → Atividades (o trabalho realizado) → Entregáveis (produtos entregues) → Resultados (mudanças organizacionais em 1–3 anos) → Impacto (resiliência de longo prazo e continuidade dos negócios).
Este modelo trata de um desafio crítico: uma grande interrupção, ataque cibernético ou desastre natural pode paralisar serviços essenciais. Sistemas Tier-1 devem ser recuperados em horas, não em dias, com tolerância zero à perda de dados. O modelo inclui um painel de KPIs com metas mensuráveis (RTO ≤ 4 horas, RPO ≤ 15 minutos, taxa de sucesso dos exercícios ≥ 95% e cobertura de DR de 100% para sistemas Tier-1), uma seção Premissas para documentar as dependências do programa e uma seção Fatores Externos para reconhecer forças fora do seu controle.
Quem pode usar
Este modelo é destinado a:
Líderes de TI e times de infraestrutura que executam iniciativas de DR
Gerentes de DR e de Continuidade de Negócios que planejam e coordenam programas de recuperação
Profissionais de segurança e risco que avaliam e mitigam riscos de desastres
Times de conformidade e auditoria que verificam a prontidão para DR e a conformidade regulatória
CIOs, CTOs e executivos que patrocinam, financiam e governam a estratégia de DR
Planejadores de continuidade de negócios que integram o DR à resiliência empresarial
Auditores e membros do conselho que precisam de uma visão clara da lógica do programa, da responsabilidade e do ROI
Como usá-lo
Comece com a declaração de desafio: confirme que ela reflita com precisão o contexto de risco de desastres da sua organização e a tolerância a tempo de inatividade e perda de dados.
Preencha a coluna INPUTS: documente o orçamento real de DR, a composição do time, a capacidade do site secundário ou na nuvem, as ferramentas de backup e replicação, os relatórios de BIA, o inventário de ativos, os SLAs de fornecedores e as políticas de governança.
Mapeie suas ACTIVITIES: liste o trabalho específico que seu time realiza: análise de impacto (BIA), desenvolvimento do plano de DR e do runbook, implantação da replicação, exercícios programados (tabletop, failover, em grande escala), treinamento do time e revisões trimestrais do plano.
Defina OUTPUTS: identifique os entregáveis concretos que cada atividade produz: planos de DR aprovados, cobertura de 100% dos sistemas Tier-1, relatórios de exercícios concluídos, time treinado e certificado, RTO/RPO documentados por aplicativo.
Defina os resultados: Descreva as mudanças comportamentais e operacionais esperadas em 1–3 anos: metas de RTO/RPO atingidas de forma consistente, a equipe responde com confiança durante incidentes, menos falhas de recuperação, DR incorporado à gestão de mudanças, confiança das áreas de negócio na continuidade de TI e requisitos de conformidade atendidos.
Articule o impacto de longo prazo: Capture o estado resiliente almejado: serviços críticos sobrevivem a qualquer desastre, continuidade do negócio assegurada, reputação protegida e uma cultura de preparo sustentada.
Atualize o painel de KPIs: Substitua metas provisórias pelos objetivos específicos da sua organização para RTO, RPO, frequência de simulações e objetivos de cobertura.
Revise premissas e fatores externos: Ajuste essas seções para refletir seu ambiente, dependências e riscos além do seu controle.
Use o modelo concluído: apresente-o em revisões de governança, propostas orçamentárias, briefings para stakeholders e comunicações do programa de DR para demonstrar claramente a lógica do programa, seu valor e a prestação de contas.
Saúde!
Khawaja Rizwan