Model logiczny gotowości DR
Streszczenie
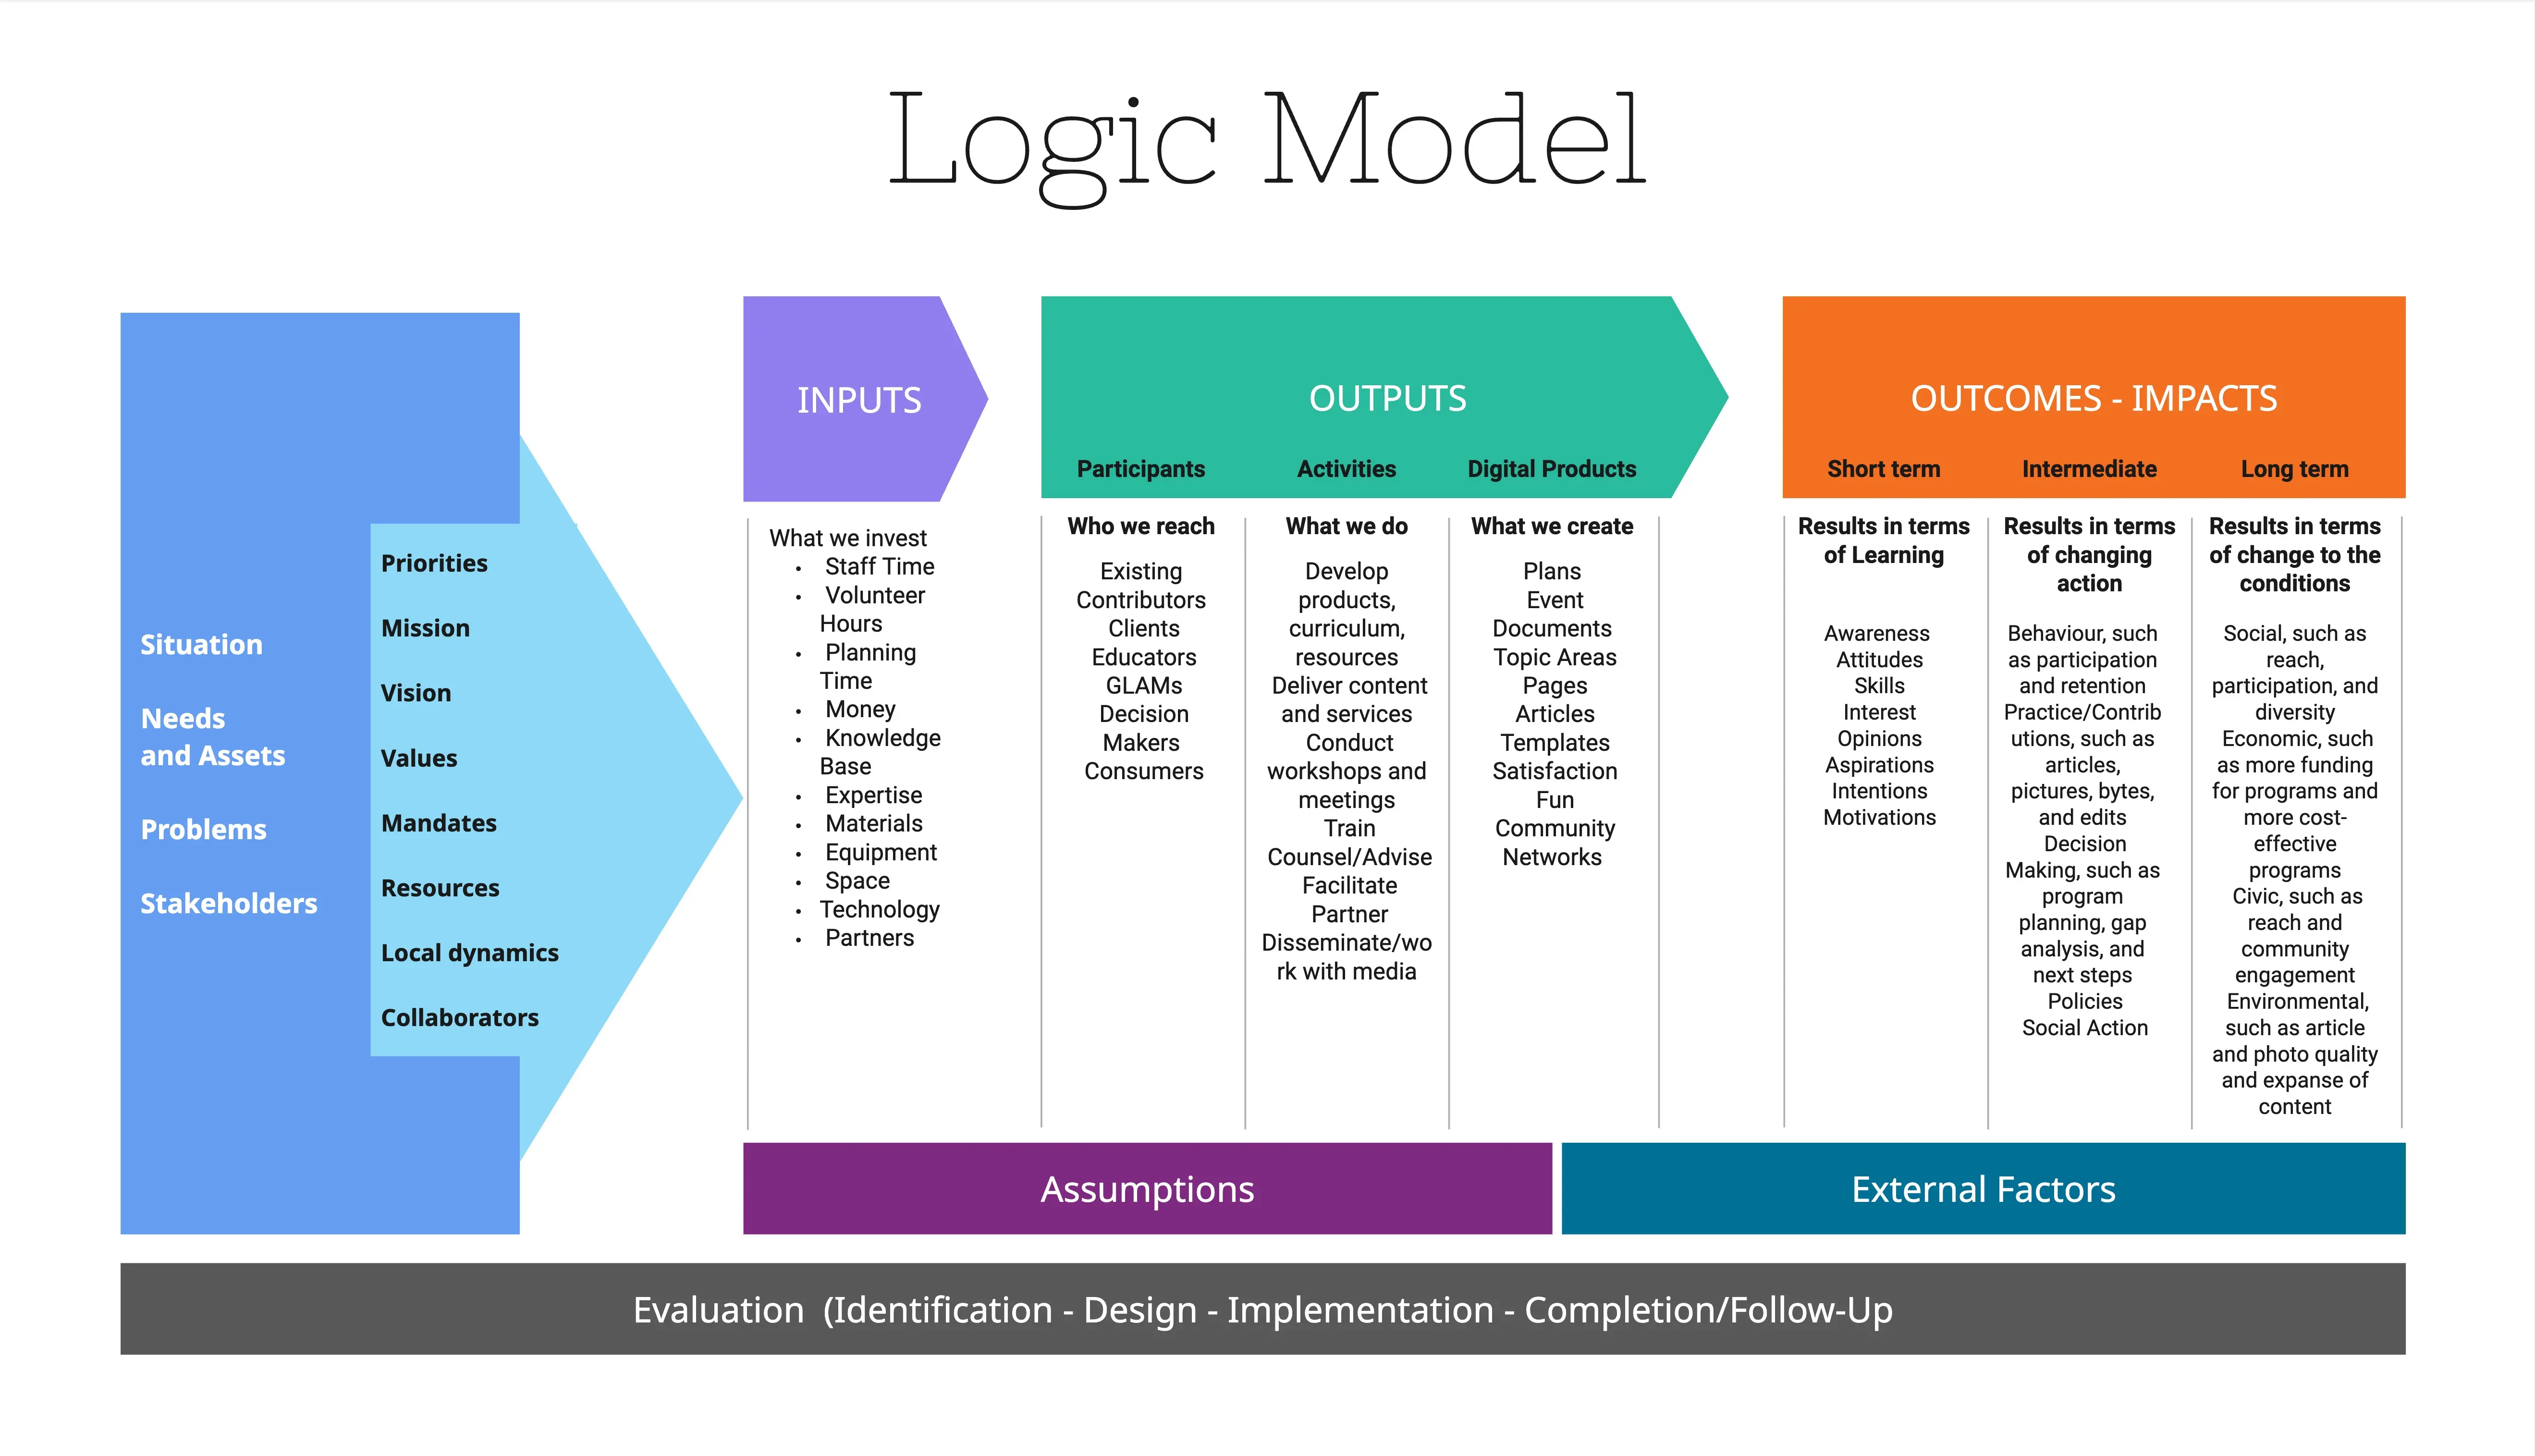
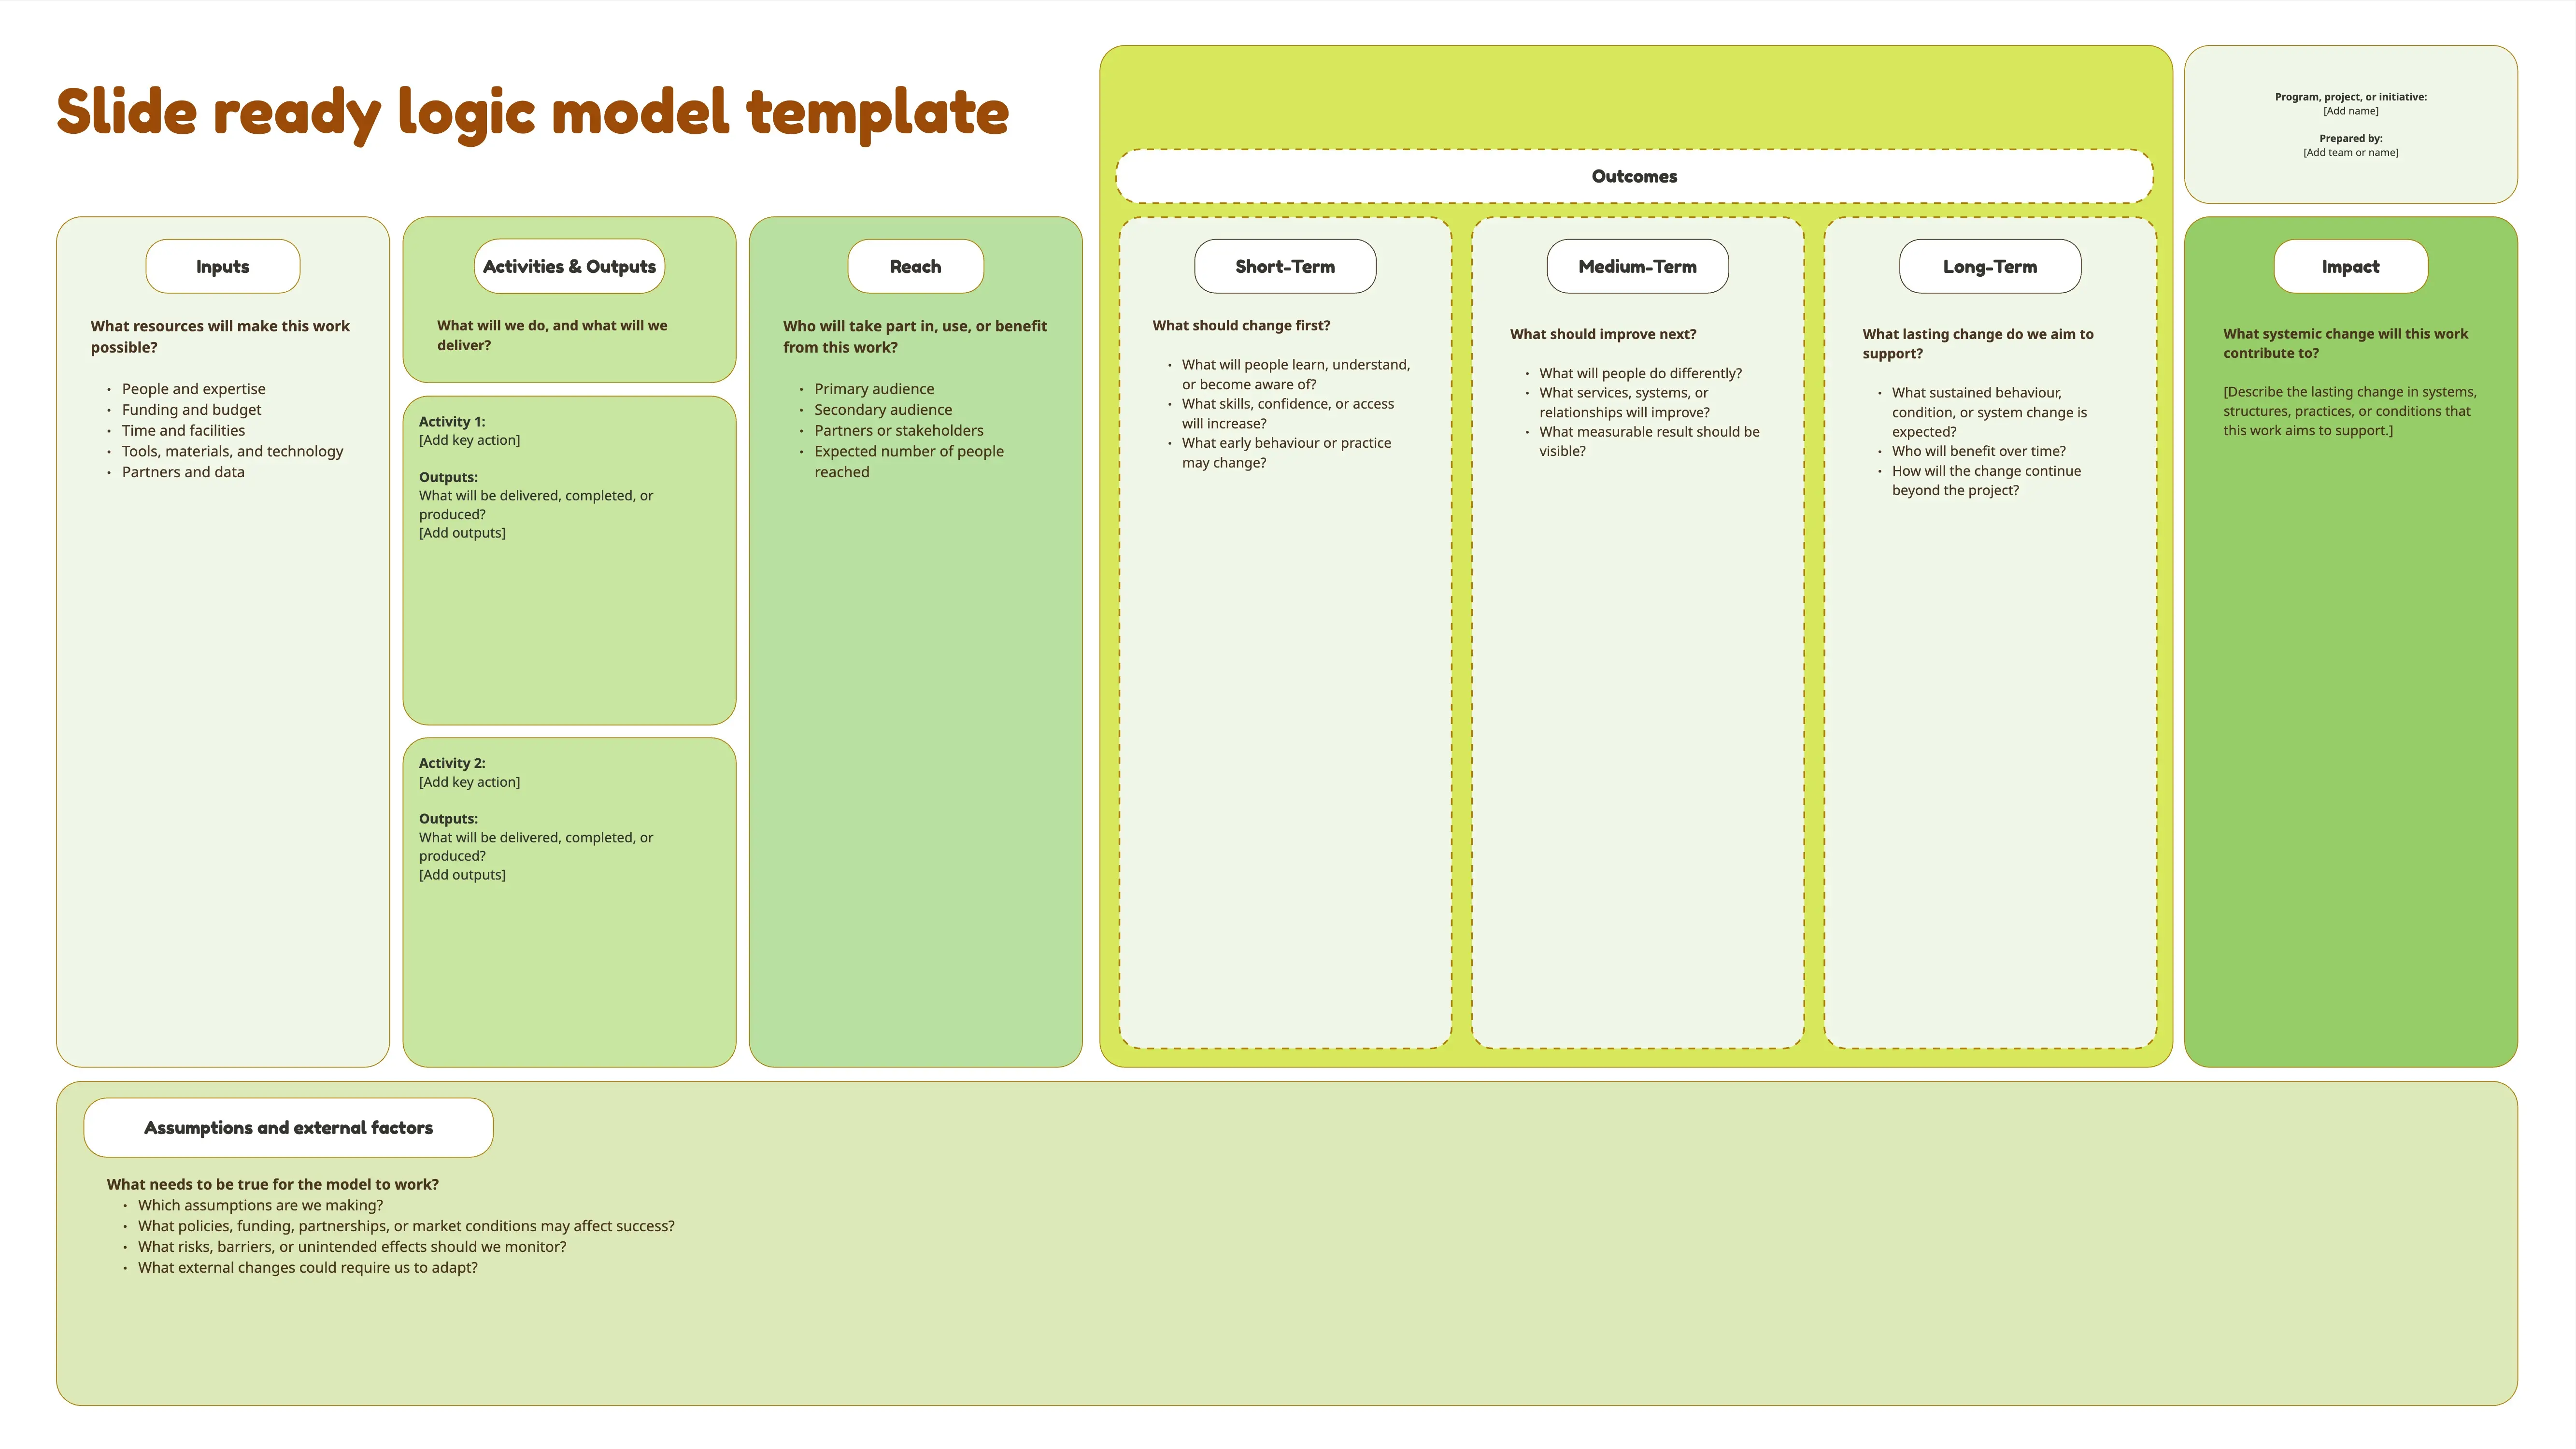
Model logiczny gotowości do odzyskiwania po awarii (DR) to ramy planowania strategicznego i komunikacji, które odwzorowują pełny łańcuch przyczynowo-skutkowy programu odzyskiwania po awarii. Wyznacza ścieżkę: Wejścia (zasoby i inwestycje) → Działania (prace, które wykonujesz) → Produkty (elementy będące wynikiem działań) → Rezultaty (zmiany organizacyjne w okresie 1–3 lat) → Wpływ (długoterminowa odporność i ciągłość działania).
Ten szablon odnosi się do krytycznego problemu: poważna awaria, atak cybernetyczny lub klęska żywiołowa mogą zatrzymać usługi krytyczne dla działalności. Systemy Tier-1 muszą zostać przywrócone w ciągu godzin — nie dni — przy zerowej tolerancji dla utraty danych. Model zawiera panel KPI z mierzalnymi celami (RTO ≤ 4 godz., RPO ≤ 15 min., wskaźnik powodzenia ćwiczeń ≥ 95% oraz 100% pokrycia DR systemów Tier-1), sekcję Założenia do dokumentowania zależności programu oraz sekcję Czynniki zewnętrzne do uwzględnienia sił poza Twoją kontrolą.
Kto może z niego korzystać
Szablon jest przeznaczony dla:
Liderzy IT i zespoły infrastruktury którzy realizują inicjatywy DR
Menedżerowie ds. DR i ciągłości działania którzy planują i koordynują programy odzyskiwania
Specjaliści ds. bezpieczeństwa i ryzyka którzy oceniają i ograniczają ryzyko katastrof
Zespoły ds. zgodności i audytu które weryfikują gotowość DR i zgodność z przepisami
CIO, CTO i kadra kierownicza którzy sponsorują, finansują i nadzorują strategię DR
Planiści ciągłości działania którzy integrują DR z odpornością przedsiębiorstwa
Audytorzy i członkowie zarządu którzy potrzebują jasnego obrazu logiki programu, odpowiedzialności i ROI
Jak tego używać
Zacznij od opisu wyzwania — Upewnij się, że dokładnie odzwierciedla kontekst ryzyka katastrofy oraz tolerancję Twojej organizacji na przestoje i utratę danych.
Wypełnij kolumnę INPUTS — Udokumentuj rzeczywisty budżet DR, skład zespołu, zapasową lokalizację lub pojemność w chmurze, narzędzia do backupu i replikacji, raporty BIA, inwentarz zasobów, umowy SLA z dostawcami oraz polityki zarządzania.
Zmapuj ACTIVITIES — Wypisz konkretne działania zespołu: analiza wpływu na biznes (BIA), opracowywanie planów DR i runbooków, wdrożenie replikacji, zaplanowane ćwiczenia (tabletop, przełączenia awaryjne, ćwiczenia pełnoskalowe), szkolenia personelu oraz kwartalne przeglądy planu.
Zdefiniuj OUTPUTS — Określ konkretne rezultaty każdej aktywności: zatwierdzone plany DR, 100% pokrycie systemów Tier-1, ukończone raporty z ćwiczeń, przeszkolony i certyfikowany personel, udokumentowane RTO/RPO dla każdej aplikacji.
Określ REZULTATY — Opisz spodziewane zmiany w zachowaniu i funkcjonowaniu w ciągu 1–3 lat: konsekwentne osiąganie celów RTO/RPO, personel reaguje pewnie podczas incydentów, mniej niepowodzeń przy odzyskiwaniu, DR zintegrowane z zarządzaniem zmianami, zaufanie biznesu do ciągłości działania IT oraz spełnione wymogi zgodności.
Opisz długoterminowy WPŁYW — Ujmij stan odporności, do którego dążysz: usługi krytyczne przetrwają każdą awarię, zapewniona ciągłość działania biznesu, ochrona reputacji oraz utrwalona kultura gotowości.
Zaktualizuj panel KPI — Zastąp wartości zastępcze konkretnymi dla twojej organizacji celami dotyczącymi RTO, RPO, częstotliwości ćwiczeń i zakresu pokrycia.
Przejrzyj Założenia i Czynniki zewnętrzne — Dostosuj te sekcje tak, aby odzwierciedlały twoje środowisko, zależności i ryzyka, na które nie masz wpływu.
Wykorzystaj gotowy model — przedstaw go w przeglądach zarządzania, propozycjach budżetowych, briefingach dla interesariuszy oraz w komunikacji programu DR, aby jasno pokazać logikę programu, jego wartość i rozliczalność.
Pozdrawiam!
Khawaja Rizwan